Dataset de Empresas da Grande Vitória: de 344 mil para 367 mil CNPJs, com processos, sócios e riscos
· Dados Abertos, Python, ETL, SQLite, Due Diligence, Mapas
O Dataset de Empresas da Grande Vitória é o maior projeto de dados que mantenho: uma base aberta com todas as empresas ativas dos 7 municípios da região metropolitana do Espírito Santo, cruzadas com dezenas de fontes públicas oficiais. Começou em julho com o cadastro da Receita; hoje tem sócios, processos judiciais, dívida ativa, sanções, contratos públicos, riscos ambientais, due diligence dos sócios e uma nota de integridade por empresa. Este post conta o que mudou, o que funciona hoje, quanto tempo cada atualização leva e o que deu trabalho.
- Painel: empresas.brunokobi.tech
- API REST: empresas.brunokobi.tech/docs
- Código e dataset: github.com/brunokobi/projeto_grande_vitoria_empresas
TL;DR
- De 344.130 empresas em julho para 366.995 hoje (base de outubro/2026 da Receita), com 242.897 sócios.
- 100% das empresas no mapa: no começo eram menos de 3 mil com coordenadas.
- 4,61 milhões de registros de processos judiciais, com todas as empresas e sócios já consultados.
- Mais de 25 fontes oficiais cruzadas: Receita, PGFN, CGU, TCEES, IBAMA, MTE, TSE, PNCP, INPI, Banco Central, CVM, OFAC, ONU, Offshore Leaks e outras.
- O dataset publicado atualiza a cada 2 horas; o cadastro e as fontes mensais rodam todo dia 1º; os processos rodam à parte, por dias, numa máquina de casa.
1. O crescimento da base
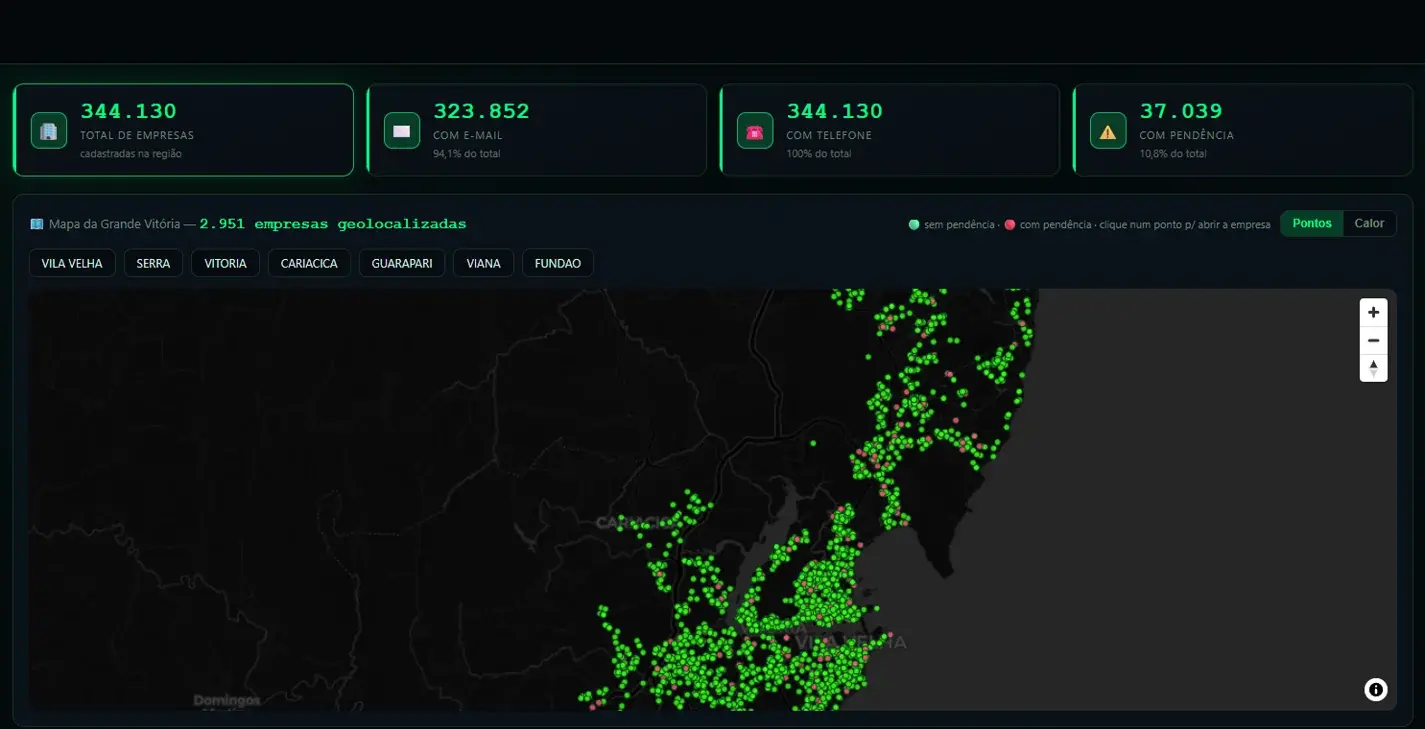
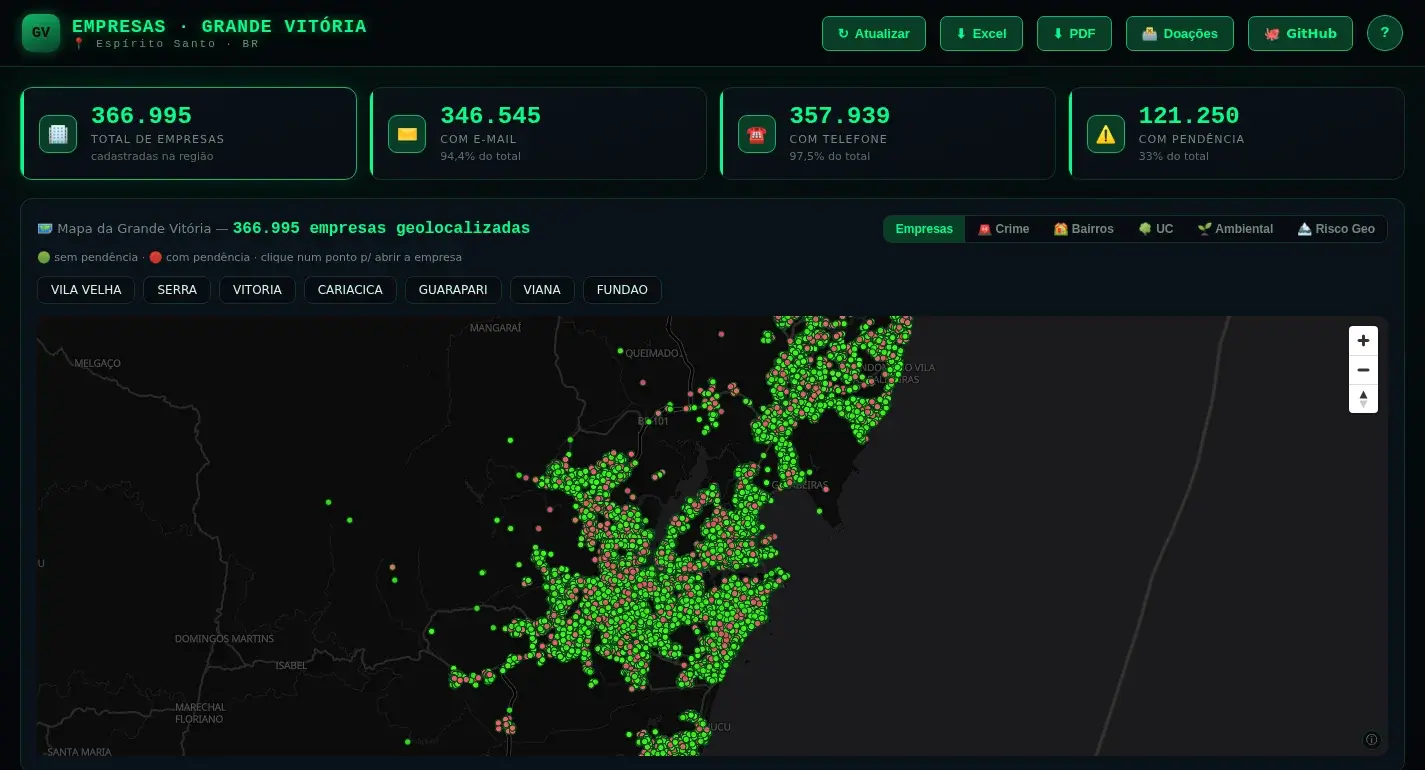
A contagem de empresas acompanha a base que a Receita Federal publica uma vez por mês:
- Julho/2026: 344.130 empresas ativas na primeira carga.
- Setembro/2026: 351.824, já pela atualização mensal automática.
- Novembro/2026: 366.995, com a base de outubro.
O salto de setembro para novembro esconde um bug. A atualização mensal rodava todo dia 1º sem erro nenhum, mas os arquivos baixados tinham nome fixo, e o script achava que já tinha o download do mês. Na prática, ele reaproveitava os arquivos de julho todo mês. Quando percebi, em 7 de novembro, corrigi o script para apagar o cache e os checkpoints antes de cada execução e recarreguei todas as fontes do zero entre 6 e 7 de novembro. Foi aí que a base chegou a 366.995 empresas e a dívida ativa passou a ser a do 3º trimestre de 2026.
Lição: um job que "roda sem erro" não é o mesmo que um job que "traz dado novo". Hoje o README mostra a data da base da Receita ao lado do total.
2. O que foi adicionado
Mapa com todas as empresas
Cada endereço foi geocodificado pelo OpenStreetMap (Nominatim), que permite cerca de 1 consulta por segundo. Para mais de 360 mil empresas isso levou dias, rodando direto na VPS até esvaziar a fila. Hoje está em 100%, e as empresas novas de cada mês entram no cron mensal. Se uma empresa ainda não tem coordenada, o mapa a localiza na hora pelo endereço.
Em cima dos pontos entraram camadas geográficas, todas cruzadas por localização (ponto dentro do polígono ou distância):
- Unidades de conservação e zonas de amortecimento (MMA e IEMA-ES): 10.771 empresas dentro delas.
- Proximidade ambiental (fiscalização, barragens e outorgas de água): 86.572 empresas a até 500 m de um ponto.
- Risco geológico e de inundação (Defesa Civil-ES, CPRM e prefeituras): 18.277 empresas dentro de um setor de risco.
Situação jurídico-fiscal
- Dívida ativa da União (PGFN): 201.098 inscrições em 39.586 empresas, somando R$ 41,7 bilhões.
- Sanções federais (CEIS, CNEP, CEPIM, acordos de leniência) e estaduais (TCEES).
- Infrações ambientais do IBAMA e a Lista Suja do trabalho escravo do MTE.
- Contratos públicos pelo PNCP (municipais, estaduais e federais) e pelo Portal da Transparência.
- Benefícios fiscais federais e o incentivo de ICMS estadual (COMPETE-ES), marcas no INPI e vínculo político dos sócios pelo TSE.
Processos judiciais
Foram 4,61 milhões de registros, com todas as empresas e sócios consultados; 96.403 empresas aparecem como ré em processo próprio. Ao abrir um processo no painel, o sistema busca na hora o assunto, as instâncias, as movimentações e as publicações, e confere se a empresa consta mesmo entre os destinatários oficiais.
Due diligence dos sócios
A novidade de novembro: cada sócio é cruzado com dívida ativa em nome próprio, servidores federais, expulsões do serviço público, Bolsa Família, embargos do IBAMA, inabilitados do Banco Central, processos da CVM, sanções da OFAC, da ONU e do Reino Unido e o Offshore Leaks do ICIJ. A dívida ativa da União do próprio sócio, por exemplo, aparece em mais de 24 mil empresas.
Como a Receita publica o CPF mascarado, o cruzamento usa os 6 dígitos do meio do CPF mais o nome completo, e o resultado é sempre mostrado como possível correspondência, com o critério usado.
Grupo econômico, risco-país e nota de integridade
- Grupo econômico: a partir da base nacional de sócios da Receita, o painel mostra em que outras empresas do Brasil os mesmos sócios aparecem.
- Risco-país: sócios estrangeiros cruzados com as listas do GAFI e o Índice de Percepção da Corrupção.
- Nota de integridade: Baixo, Moderado, Alto ou Crítico, com fatores, pesos e tetos documentados. É pré-calculada para todas as empresas antes de cada publicação e vira filtro no painel.
- Menções na mídia: Google Notícias e GDELT, com destaque para manchetes com termos como fraude ou operação.
Dossiê com IA e pesquisa acadêmica
Um botão gera um dossiê de due diligence: um score de risco de um modelo XGBoost treinado no próprio dataset, a rede de sócios e endereços em comum num grafo Neo4j e um parecer escrito por um LLM só em cima dos dados já consultados. O grafo vem da pesquisa que desenvolvo como aluno especial do mestrado na UFES, que compara modelos tabulares e redes neurais de grafo para prever risco a partir das conexões entre empresas. O preprint está publicado no Zenodo (DOI 10.5281/zenodo.21961063).
Acesso por API e MCP
Tudo que o painel mostra também sai pela API REST (FastAPI), por exportação em Excel e PDF e por um servidor MCP, que deixa assistentes de IA consultarem a base direto: buscar empresas, buscar por raio a partir de um endereço, abrir a visão 360º e o ranking de doações eleitorais.
3. Quanto tempo leva cada atualização
- A cada 2 horas: a VPS tira um snapshot consistente do banco, comprime e publica como Release no GitHub. Meia hora depois, o painel confere se o arquivo mudou e troca o banco de forma atômica, sem derrubar o serviço.
- Todo dia 1º, às 3h: a atualização mensal roda em sequência cadastro, geocodificação das novas, camadas geográficas, sócios, JUCEES, sanções, TCEES, IBAMA, TSE, PNCP, INPI, COMPETE-ES, PEP e due diligence. Enquanto ela roda, a publicação de 2 em 2 horas fica parada por uma trava, para não publicar um banco pela metade.
- Geocodificação: cerca de 1 empresa por segundo; a base inteira levou dias. Hoje só as empresas novas do mês passam por ela.
- Processos judiciais: cerca de 1 consulta por segundo e mais de meio milhão de nomes entre empresas e sócios, o que dá dias de execução contínua. Roda com checkpoint, então pode parar e continuar.
- PEP: uma consulta por sócio distinto, cerca de 142 mil nomes, horas de execução.
- Dossiê com IA: de 30 a 90 segundos por empresa, sob demanda.
4. As dificuldades
O CNJ bloqueou a VPS
A busca de processos começou como um serviço 24 horas na VPS, até a API do CNJ passar a responder 403 só para ela. Testei a mesma consulta de dois lugares: da VPS dava 403, de uma conexão residencial dava 200. É um bloqueio comum de sistemas de governo contra faixas de IP de provedores de nuvem. A solução foi rodar essa etapa na máquina de casa e mesclar o resultado no banco da VPS antes de publicar, sem sobrescrever o que a VPS já tinha processado.
O DataJud não diz quem são as partes
A API pública do DataJud parecia a fonte óbvia para processos, mas ela não expõe as partes (CPF ou CNPJ): é impossível achar os processos de uma empresa por ela. A busca foi feita pelo DJEN, o diário de comunicações do CNJ, que permite procurar pelo nome da parte. O DataJud voltou depois, só para detalhar um processo já encontrado, pelo número.
Uma regressão no dataset público
No fim de julho, o dataset público regrediu: uma publicação subiu um banco sem parte do progresso que já estava publicado. Desde então, cada publicação de 2 horas primeiro mescla o que já está publicado e só depois sobe a versão nova.
Fontes que mudam, escondem ou mentem em silêncio
- A Receita trocou o servidor de download, e a URL antiga passou a dar 404. O código agora resolve o link a cada execução.
- A Lista Suja do trabalho escravo é um PDF atrás de um firewall instável, com URL que muda a cada semestre.
- A API do PNCP devolve vazio, sem erro, quando a janela de datas passa de um ano. O histórico é varrido em fatias de 365 dias.
- O TSE publica o CPF do candidato anonimizado, mas o do doador não. O cruzamento útil foi o sócio como doador: doação de empresa é proibida desde 2015.
- Ler a prestação de contas eleitoral do ES inteira em memória estourou o container com 3 GB, e foi preciso subir para 6 GB.
- Arquivos com codificações diferentes: Receita, PGFN e CGU em latin-1, IBAMA em UTF-8.
Fontes que não deram certo
O repositório de extração mantém uma lista das fontes testadas e descartadas, com o motivo, para ninguém testar de novo:
- Interpol: bloqueia acesso automatizado. A parte Interpol–ONU vem pela lista da ONU.
- Sanções da União Europeia e lista do Banco Mundial: exigem cadastro ou chave.
- BNDES, RAIS e CAGED: sem CNPJ nos dados abertos.
- Conselhos de classe (CREA, CRM, OAB): só consulta individual, inviável para 360 mil empresas.
- Querido Diário: não respondeu para as 7 cidades no teste.
- TCU (inabilitados): o serviço estava fora do ar na implantação.
Banco que é lido e escrito ao mesmo tempo
O SQLite é lido pelo painel enquanto as etapas escrevem. O banco usa WAL e espera de bloqueio, cada etapa grava em lotes com checkpoint e a publicação usa o backup nativo do SQLite, que tira uma cópia consistente mesmo com o pipeline rodando.
LGPD
Os dados são públicos, mas o dataset junta dados de pessoas: nomes de sócios, CPF mascarado e endereços. Os cruzamentos por pessoa sempre aparecem como possível correspondência, e o projeto pede uso responsável conforme a LGPD.
Principais lições
- Confira o dado, não só o status do job. O cron mensal passou meses "funcionando" sem baixar nada novo.
- Fontes públicas falham em silêncio: resposta vazia, URL que muda, PDF no lugar de CSV.
- IP de nuvem pode ser bloqueado por sistemas de governo. Tenha um plano para rodar a etapa em outro lugar.
- Checkpoint em tudo que demora dias. Geocodificação e processos sobreviveram a quedas e reinícios sem perder trabalho.
- Publicação também precisa de proteção: mesclar antes de subir e usar trava contra execuções simultâneas.
- Documente o que não funcionou. A lista de fontes descartadas economiza semanas.
Para explorar a base, acesse empresas.brunokobi.tech. Se o projeto for útil, uma estrela no GitHub ajuda a dar visibilidade.